


为什么 Strata 在小显存显卡上这么快
一个 1250 亿参数的模型,跑在 12 GB 或 16 GB 显存的显卡上,读同一个模型文件,写的速度是 llama.cpp 的四倍。这里没有单一的秘诀:Strata 把整台电脑当成一条流水线,尽量少让数据挤过最窄的那根管子。
要点
Strata 是一个开源推理引擎,只为一个模型家族而写:Qwen3.8-Flash-Next。这是一个 1250 亿参数的混合专家(MoE)模型,每个 token 实际参与计算的只有约 60 亿参数。在 12 GB 的 RTX 3060 上,读同一个 GGUF 文件,它的写入速度是调优后 llama.cpp 的 4.6 倍(每秒 41.6 对 9.1 个 token),读取 32K token 提示词的速度是 3.1 倍。起作用的主要是四个思路:
- 按专家拆,而不是按层拆。 模型的 24,576 个专家按使用频率排序,显卡从每一层里留下最常用的那些,并在对话过程中持续学习。
- 三路同时开工。 每一层里,GPU 计算它手上已有的专家;CPU 在内存里就地计算缺失的专家;同时还有一部分缺失的专家经 PCIe 拷到 GPU。
- 先猜,再检查。 模型自带的多 token 预测(MTP)层先猜出最多三个 token,一次前向就把它们全部检查完,所以每一次昂贵的计算能产出两到三个 token。
- 大块流式读取。 长提示词以数千 token 为一块来读,经 PCIe 拷过去的每个专家都能被整块 token 复用。
这是一篇总览。每一部分,以及它暴露出的硬件瓶颈,之后都会单独写一篇深入文章。下文每个数字都注明来源和测试条件,完整列表在文末。
问题:1250 亿参数,12 GB 显存
混合专家模型把每个稠密前馈块换成许多小的“专家”,再由一个路由器为每个 token 挑出其中几个。Qwen3.8-Flash-Next 有 48 层,每层 512 个专家,一共 24,576 个;每一层的路由器为每个 token 挑 10 个。所以一个 token 只会碰到 480 个专家,约占全部的 2%。
正是这种稀疏性,让游戏电脑跑这个模型变得可能。Strata 推荐的最高质量版本 IQ3_S,光专家就要约 50 GB,另有一张 29 GB 的 n-gram 查找表,以及每个 token 都要用到的约 3.5 GB 权重:注意力与 DeltaNet 混合层、路由器、共享专家和输出头。没有哪张消费级显卡装得下。但一个 token 只需要那 3.5 GB 常用权重,外加约 1 GB 的专家。
Qwen3.8-Flash-Next,IQ3_S · 3.5 + 50 + 29 GB
一个 token 读取的部分 · 3.5 GB + 480 个专家 ≈ 1 GB
尺寸来自 Strata 的 Models 指南(IQ3_S 的专家在内存中约 50 GB)和论文表 1(常用权重约 3.5 GB;查找表 28.8 GB,每个 token 只读几行)。IQ3_S 下一个专家约 2 MB;480 × 2 MB ≈ 1 GB。
所以真正的问题不是怎样把 80 GB 塞进 12 GB,而是:下一个 token 要用哪 1 GB,这 1 GB 此刻在哪里,由谁来算。下面的每个设计,都在回答这个问题。
一台电脑就是一组水管
可以把 Strata 想象成水管里的水。专家、KV 缓存和激活值不断在 SSD、内存、CPU、PCIe 链路和显存之间流动。水流的速度永远快不过路径上最细的那根管子,而一台电脑里各根管子的粗细相差一个数量级以上。
理论峰值带宽,取自硬件规格,对数刻度;实际传输更低。CPU 一行是在 ModelDock 测试机(Ryzen 9 5900XT、64 GB DDR4-2133)上实测:专家计算以每秒 22–25 GB 运行,正是这套内存的上限。
由此有两个推论。第一,数据最好在它所在的地方被计算。把一个专家从内存读进 CPU,比经过一条窄 PCIe 链路推到 GPU 更便宜,所以 CPU 不是在等,而是在干实事。第二,同一张显卡放在不同的电脑里,表现可以差很多。社区公开的 Strata 报告里,单张 RTX 5070 Ti 的写入速度从每秒约 50 到 118 个 token 不等,差别来自主机的处理器、内存和引擎版本。在 ModelDock 自己的测试机上(PCIe 3.0、DDR4),把内存从 DDR4-2133 提到 DDR4-2933,写入快了约 20%,而读取 15 万 token 提示词只变化了 3.5%。哪根管子卡住了哪种速度,是第一篇深入文章的主题。
由粗到细:拆分模型的四种方式
模型装不进显存时,运行时必须决定哪些东西留在显卡上。答案一路变得越来越细:
- 整个模型都放进显存(vLLM、SGLang,或所有层都放 GPU 的 llama.cpp)。装得下时最快;对这个模型,意味着大约 100 GB 量级的显存。
- 按层拆(llama.cpp
-ngl)。前面的层在 GPU 上跑,其余在 CPU 上跑,每个 token 都要穿过慢的那一段。 - 按层卸载专家张量(llama.cpp
--n-cpu-moe或-ot)。注意力留在 GPU 上,N 层的专家挪到内存。这是今天在小显卡上跑大型 MoE 模型的常见做法。 - 按专家拆(Strata)。常用权重留在 GPU 上,剩下的显存从每一层里挑单个专家来填,按使用频率挑选;其余专家由 CPU 在原地计算。
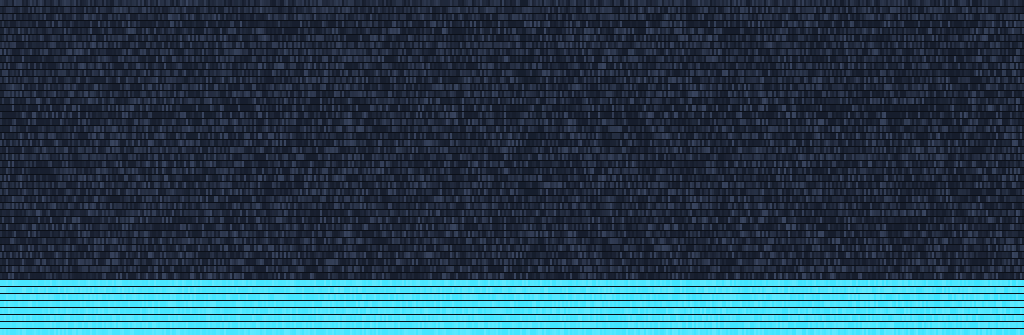
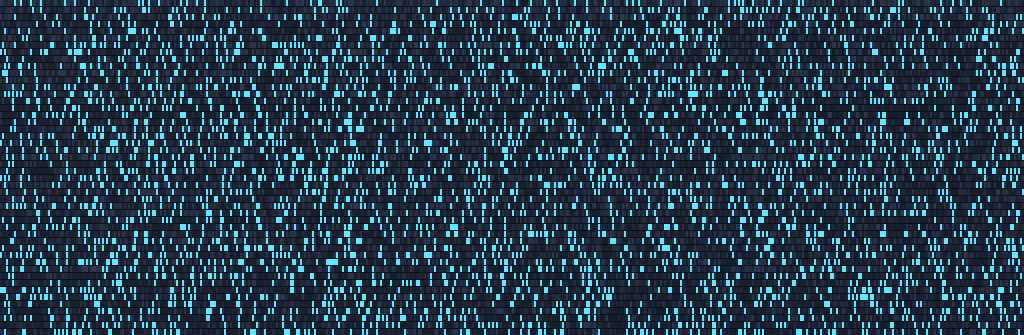
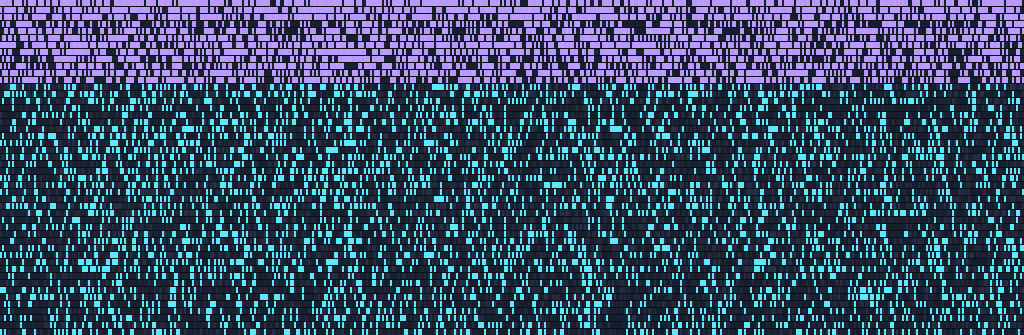
依据 Strata 随程序附带的专家画像绘制,它按使用频率为全部 24,576 个专家排序;每张卡按这个顺序为自己的层填满槽位,因此图中是近似的初始分布(自适应层会在使用中换入专家)。按层分配的那张是同等预算下的示意图。槽位数:ModelDock 测试机,2026 年 10 月 3 日。
这几张图让差别一目了然。同样的预算按整层分配时,只有落在显卡所持有的那 8 层里,专家查找才会命中显存:大约六次里中一次。Strata 把预算分摊到全部 48 层,这张卡上每层 57 到 109 个,因为热门专家本来就散落在各层。仅靠随程序附带的专家画像,12 GB 显卡就能从显存里供给约一半的路由专家;自适应层每四轮最多换入 96 个专家,朝着对话实际在用的那些靠拢,在 4K 上下文时把这个比例提到 72%。在 ModelDock 的测试机上,RTX 5070 Ti 持有的 3,600 到 4,400 个专家,只占全部专家的 15% 到 18%,却供给了 70% 到 78% 的专家查找。
Strata 自己的经验法则由此而来:每多 1 GB 显存,就能多放约 700 个专家,而显卡上的每个专家,都是 CPU 不必再算的一个。显存大小比显卡快慢更重要。
一个 token,三路工人
Strata 的论文把一个解码步骤称为“每一层,三路工人同时开工”。每一层里,GPU 先跑注意力和路由器,把选中的 10 个专家编号写进一小块锁页主机内存,也就是“门铃”。CPU 一直盯着这个门铃,而不是等驱动通知,立刻把活分下去:已在显存里的专家交给 GPU;一部分缺失的专家经 PCIe 拷到 GPU;其余的由 CPU 在存放它们的内存旁边直接计算。GPU 把结果加起来,下一层开始。整个 48 层的前向被录成一张 CUDA graph,主机从不需要等待同步式的驱动调用。
- GPU注意力、路由器:选出 10 个专家
- 门铃10 个专家编号,写在锁页主机内存里
-
GPU计算已在显存里的专家PCIe把一部分未命中拷到 GPUCPU在内存里计算其余未命中
- GPU把结果加起来;进入下一层
× 48 层,录成一张 CUDA graph
实测:一步的时间花在哪里(一张 RTX 5070 Ti)
写入速度 = 每步保留的 token 数 ÷ 每步时间:1.65 个 token ÷ 35.7 毫秒 ≈ 每秒 46 个 token。
ModelDock 测试机,在 Evidence 流程之外测量:RTX 5070 Ti 16 GB、Ryzen 9 5900XT、64 GB DDR4-2133、Windows;Strata 0.1.38 加分支补丁,IQ3_S、q4_0 KV、MTP,显存中约 3,600 个专家。一步检查一个窗口里猜出的 token。
分解图显示了时间花在哪里。在 ModelDock 的测试机上,CPU 计算专家占每一步的 45% 到 52%,速度为每秒 22 到 25 GB,正是那套 DDR4-2133 内存能给出的全部带宽:这台机器的写入速度受限于内存带宽,而不是显卡。因此有两件事能让它变快:更少的未命中(更大的显存、更好的缓存、第二张卡),以及更快的内存。PCIe 分流比例也遵循同样的逻辑。到 0.1.41 为止,这个比例只看链路速度(链路够快时为未命中的 55%);从 0.1.42 起,在单张 NVIDIA 显卡上,Strata 会在写入的最初几秒里,根据链路速度和 CPU 计算未命中专家的实测速度来微调它。
先猜,再检查
一次检查多个 token 的步骤,只比写一个 token 的步骤贵一点:常用权重只读一次,交接也只做一次,只有额外 token 路由到的专家会增加工作量。所以 Strata 让每一步都物尽其用。模型自带一个 MTP 层,最多先猜出接下来的三个 token;一次穿过全部 48 层的前向同时检查所有猜测,保留完整模型认同的那些,再补上它自己写的一个 token。
一次穿过全部 48 层的前向,同时检查三个猜测
Strata 论文第 2–3 条发现:4K 时普通解码每秒 47–57 个 token,开验证窗口后 82–92 个;贪心推测解码的输出与普通贪心解码完全一致。句子仅为示意。
在论文的参考机器上,这让 4K 上下文的写入速度从每秒 47–57 个 token 提到 82–92 个,提升 1.6 到 1.8 倍,而且输出和普通贪心解码逐 token 完全一致。草稿层放在显存里,占 0.8 GB。和 llama.cpp 的对比很能说明问题:它的 MTP 需要一个单独的 3.4 GB 草稿头,把更多专家挤到了 CPU 上,结果在这些显卡上开 MTP 反而比不开更慢。在小显卡上,推测解码只有在不占专家空间时才划算。
读长提示词:大块流式读取
读取提示词(prefill)是另一种工作负载。几千个 token 的提示词几乎会路由到每一层的每一个专家,所以缓存热门专家帮不上多少忙。Strata 的做法是把长提示词分块来读,自动设置下每块最多 8,192 个 token,也可以手动设得更大(ModelDock 测试机用的是 16,384),并在当前层做注意力的同时,经 PCIe 把下一层的专家流式送到 GPU。拷过去的每个专家都会被整块 token 使用,一次传输的成本就摊到了几千个 token 上。
Strata 社区报告,IQ3_S,读取速度(每秒提示词 token 数)。RTX 5070 Ti 和 RTX 3060 为冷缓存;RTX 3060 为 0.1.41,RTX 5090 为 0.1.39。阴影带标出 8K–16K token,提示词从这里开始填满一整块。
这几条曲线解释了用户常注意到的两件事。短提示词读得慢,因为小块同样要为它路由到的专家付传输成本:RTX 3060 读 128 token 的提示词约为每秒 50 个,读 32K 则是 820 个。一旦块被填满,读取速度几乎一路平稳到很长的上下文,因为稀疏注意力只读取有限的位置:PR #811 里的 RTX 5090 在 261,880 个 token 时仍能每秒读 5,535 个。这里 PCIe 最关键。在 ModelDock 的测试机上,一条链路曾退回到 PCIe Gen1,读取速度因此掉了大约一半,直到在 BIOS 里改回 Gen3 才恢复。
双卡接力
有两张显卡时,Strata 按层拆分:是流水线并行,而不是张量并行。第一张卡跑前面的层;第二张跑其余的层,外加输出头和草稿层;每张卡只缓存自己那些层的专家。激活值每个验证窗口在两卡之间传递一次,经锁页内存传几百 KB,所以既不需要 NVLink,也不需要点对点(P2P)支持。开启流水线窗口后,最后一张卡还在检查当前窗口时,第一张卡就已按草稿的猜测开始下一个窗口;猜错了就重做。
小卡 第 0–11 层
大卡 第 12–47 层、输出头、草稿层
CPU 两张卡都没有的专家
交接下一张卡等待锁页内存里的一个标志:每个窗口传几百 KB,不需要 NVLink 或 P2P。
流水线大卡检查窗口 K 时,小卡按草稿的猜测开始 K+1;猜错了就重做。
CPU 分流CPU 计算两张卡都没有的专家,与两张卡并行。
长提示词专家经 PCIe 一块一块地流式传输(测试机上每块 15,360 个 token);只有一两块时,两个阶段仍是一个接一个地跑。
示意图,不按比例。按层拆分和流水线窗口:Strata 的 Multi-GPU 指南;标志交接来自 Hardin22/Strata-DualGPU 分支。
在 ModelDock 的测试机上,收益主要来自容量,而不是流水线本身。两张卡共持有 8,412 个专家,而不是 4,176 个;CPU 每层每步要算的专家少了 59%;一步从 36.7 毫秒缩短到 23.8 毫秒。流水线本身只贡献了约 4% 到 6%。读取并没有变快。只有一两块时,两个阶段仍是一个接一个地跑,所以 8K 到 64K 的提示词读得慢了 18% 到 53%,直到 150K 时两张卡才追平一张。
写入,短对话 tok/s
+54%写入,15 万 token 上下文 tok/s
+37%读取 15 万 token 提示词 tok/s
≈显存中的专家
×2CPU 每层每步要算的专家
−59%每步时间,短对话 ms
−35%但中等长度的提示词在两张卡上读得更慢(tok/s,一张 → 两张)
ModelDock 测试机,2026 年 10 月 3 日,在 Evidence 流程之外测量。一张卡:RTX 5070 Ti 16 GB,映射式专家。两张卡:RTX 3060 12 GB(第 0–11 层)+ RTX 5070 Ti(第 12–47 层、输出头、草稿层),各为 PCIe 3.0 x8,常驻专家,流水线窗口。Ryzen 9 5900XT、64 GB DDR4-2133、Windows;IQ3_S、q4_0 KV、MTP、贪心解码;Strata 0.1.38 + architectds/Strata 分支中的 Hardin22/Strata-DualGPU(#642)。两边都用映射式专家时,两张卡测得 68.3 / 59.7 / 1,609。
公开报告也指向同样的结论。在同一台主机上用两张 RX 6900 XT(Strata 0.1.40.1,PR #1270),与单卡相比,拆分让写入快了 32%,读取快了 66%,而 4K 提示词的读取慢了 3%。只有当多出来的显存能省掉 CPU 的工作时,拆分才划算;它不会让任何一张卡本身变快。
实测:Strata 对比 llama.cpp
目前最公平的对比,是 Strata 自己在 2026 年 10 月 6 日做的对照测试:两个引擎读同一个 IQ3_XXS GGUF 文件,llama.cpp v0.6.0 经过 -ncmoe 和 -ub 扫描调优,提示词也相同。Strata 在所有测量项上都领先。
RTX 3060 12 GB · 写入,4K 提示词 tok/s
4.6×RTX 3060 12 GB · 读取 32K 提示词 tok/s
3.1×Tesla P100 16 GB · 写入,32K 提示词 tok/s
3.6×Tesla P100 16 GB · 读取 32K 提示词 tok/s
2.1×RTX 5070 12 GB · 读取 32K 提示词 tok/s · 仅一轮
8.8×Strata 于 2026 年 10 月 6 日的对照测试:两个引擎读同一个 Qwen3.8-Flash-Next GSQ-RCO IQ3_XXS 文件;llama.cpp v0.6.0(b11429)经 -ncmoe 和 -ub 扫描调优(RTX 5070 用 --fit on);温度 0 下 256 token 回答的中位数;Strata 使用安装程序给出的配置(MTP、int8 KV)。RTX 3060:46 GB 内存,Linux;Tesla P100:62 GB,Linux;RTX 5070:64 GB,Windows。
报告本身写明了局限:轮次少、调优扫描范围小、没有试按张量的 -ot 规则,而且给 llama.cpp 用的 MTP 头不是模型原生的那个。作者认为更充分的 llama.cpp 调优可能多出几个百分点,但不会抹平 4 倍的差距。另一类机器上的对比也指向同一方向:在 128 GB 统一内存的 AMD Ryzen AI Max+ 395 上,Strata 0.1.40 在 128K 上下文时的写入速度约为每秒 51 个 token(UD-IQ4_XS,开 MTP),而 llama.cpp 的 Vulkan 版本用更大的 UD-Q4_K_XL 文件、不开草稿模型,约为 15.5 个。两者的量化和配置不同,所以只能看方向,不能看倍数。
Strata 并非处处最快。整个模型都装进显存时,服务器引擎更强:96 GB 的 RTX PRO 6000 跑 SGLang(NVFP4),写入每秒 171 个 token,64K 时读取超过 10,000 个;而 RTX 5090 跑 Strata 是 168 和 5,803。Strata 解决的是“模型装不下”,它不能替代全显存的服务器。
代价
- 只支持一个模型家族。 Strata 为 Qwen3.8-Flash-Next 及其微调版本而写,不是通用运行时。
- 短提示词和第一条消息。 512 token 的提示词,读取速度只有长提示词的一小部分;在 12 GB 显卡上,一段全新的 3 万 token 对话大约要读一分钟。之后的对话会复用上下文,只读新增的部分。
- 内存依然重要。 专家放在内存里:IQ3_S 约 50 GB,Q2_0 约 34 GB,系统另需约 10 GB。对显存大、内存小的机器,有一个低内存模式。
- MTP 收益较小。 是 1.6 到 1.8 倍,而整个模型都在显存里的引擎能报出 2.5 到 3 倍,因为每多猜一个 token,它就会路由到自己的一批 CPU 专家。
- 不同设置下不是逐位一致。 贪心推测解码与贪心解码一致,但 CPU 和 GPU 内核的舍入方式不同,自适应缓存、CPU 分流和尾部跳过也会改变最后几位,所以两种配置跑久了可能出现分歧。
- 默认一次处理一个请求。 在 12 GB 显卡上开并行槽位会更慢。
常见问题
Strata 能在 8 GB 显卡上运行吗?
Strata 面向 12 GB 及以上的 NVIDIA 和 AMD 显卡。低于这个容量,放下常用权重、KV 缓存和草稿层之后,留给专家缓存的显存就太少了。
Strata 需要多少内存?
所有专家都放在内存里:Q2_0 约 34 GB,IQ2_XS 35.5 GB,IQ3_XXS 43 GB,IQ3_S 50 GB,另需约 10 GB 给 Windows 和其他程序。64 GB 内存能装下所有尺寸;48 GB 能装下 Q2_0 和 IQ2_XS。
Strata 比 llama.cpp、Ollama 或 LM Studio 更快吗?
在同一个 GGUF 文件和 12 到 16 GB 显卡上,Strata 公开的对照测试测得其写入比 llama.cpp 快 3.0 到 4.7 倍,读取快 1.6 到 8.8 倍。ModelDock 目前没有公开这个模型在这些显卡上用 Ollama 或 LM Studio 的测量数据。
两张显卡需要 NVLink 或同型号吗?
不需要。按层拆分时,每个窗口经锁页系统内存传递几百 KB,所以不同型号的卡无需 NVLink 或 P2P 也能配合;ModelDock 的测试机就是一张 RTX 3060 搭一张 RTX 5070 Ti。较快的卡放在最后,因为它要跑输出头和草稿层。
该买更大的显存,还是更快的显卡?
对这个模型,通常是更大的显存更划算:每多 1 GB 能多放约 700 个专家,每一个都是 CPU 不必再算的。显卡周围那台电脑的内存和 PCIe 也很重要,这正是第一篇深入文章的主题。
怎样测我自己的电脑?
使用 ModelDock 测速:把一行文字贴给你的 AI 智能体,它会跑一次标准的本地基准测试,并返回一张分享卡。在 排行榜 和 Benchmark 工作台里比较不同机器。
接下来
这篇总览是一张地图。之后的每篇深入文章会把其中一部分讲透:
- 不同机器的不同瓶颈。 内存带宽、PCIe 代数和通道数、DDR4 对 DDR5:为什么同一张 RTX 5070 Ti 换一台电脑能快一倍,以及为什么老平台需要一张大显存卡,而新平台可以用两张小卡。
- 专家缓存。 专家画像、自适应换入,以及命中率为什么会在长对话中下降。
- 先猜,再检查。 当模型大部分都在内存里时的 MTP 推测。
- 双卡接力。 拆分点、流水线窗口,以及经锁页内存的交接。
- 长提示词。 分块大小、PCIe 流式传输,以及短提示词的 CPU 分流。
来源与测试条件
- Strata(MIT 许可),2026 年 10 月 10 日发布的 0.1.42:How it works、Models、Multi-GPU,以及论文 Running a 125-Billion-Parameter Model on a Normal PC(2026 年 9 月;参考机器:RTX 5070 12 GB、64 GB DDR5、六核)。
- Strata 对比 llama.cpp v0.6.0,2026 年 10 月 6 日:IQ3_XXS GGUF;RTX 3060 12 GB 配 46 GB 内存(Linux),Tesla P100 16 GB 配 62 GB(Linux),RTX 5070 12 GB 配 64 GB(Windows,仅一轮,llama.cpp
--fit on);取 256 token 回答的中位数。 - 专家分布图:依据 Strata 随程序附带的专家画像绘制,它为全部 24,576 个专家排了序;每张卡按这个顺序为自己的层填满槽位。图中是近似的初始分布,自适应层会在使用中调整它。
- ModelDock 测试机,2026 年 10 月 3 日,在 ModelDock Evidence 流程之外测量:RTX 5070 Ti 16 GB 与 RTX 3060 12 GB(PCIe 3.0,双卡时各 x8)、Ryzen 9 5900XT、64 GB DDR4-2133、Windows;Qwen3.8-Flash-Next GSQ-RCO IQ3_S、q4_0 KV、MTP、贪心解码;Strata 0.1.38 加上 architectds/Strata 分支中的 Hardin22/Strata-DualGPU 补丁(#642)。“短对话”是三条聊天提示词、各回答 400 token;“150K”是一份冷启动的 150,228 token 代码提示词。
- 读取曲线:RTX 5070 Ti 配 Core Ultra 7 265K(issue #791,IQ3_S,冷缓存);RTX 3060 12 GB 配 Core i7-12700(PR #1725,0.1.41,IQ3_S,冷缓存);RTX 5090 配 Ryzen 7 9700X(PR #811,0.1.39,IQ3_S)。
- 同一主机上的两张 RX 6900 XT,Strata 0.1.40.1,IQ3_S,131K 上下文(PR #1270)。
- Ryzen AI Max+ 395:Strata v0.1.40 发布说明;llama.cpp b10707 Vulkan(soothill.io,2026 年 8 月 27 日)。
- 全显存参照:RTX PRO 6000 96 GB 跑 SGLang,NVFP4(结果)。
- RTX 5070 Ti 在不同主机上的分布及其他硬件记录:ModelDock Data 与 Evidence。