


ModelDock 技術インサイト
実際の仕事でのローカル AI システムの挙動。
モデル実行時、コンテキスト、ハードウェア、エージェントの挙動がどう作用し合うかを扱う短い実用ノートです。ベンチマーク測定の代替ではなく、その解釈のための枠組みです。
最新ハードウェア選び · 約10分
ローカル AI ハードウェアの価格性能フロンティア
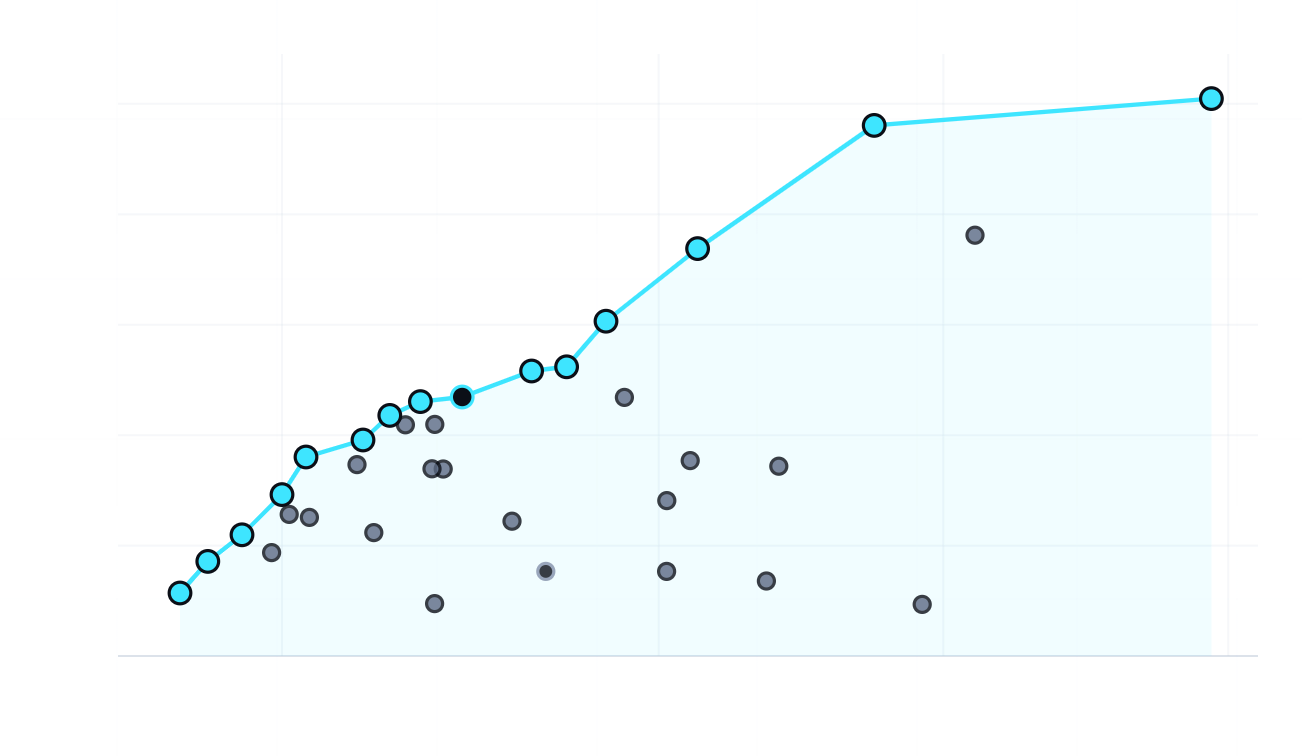
同じ予算で最も多くのローカル AI 処理をこなすマシンはどれか。価格と 1 日の処理量・書き込み速度・読み取り速度のライブなパレートフロンティアと、その計算方法。
- 6
- 通りの見方:3 種の出力 × 2 種のコスト
- ライブ
- データを公開するたびに描き直す
- 10%
- 準フロンティア:出典のばらつきで区別できない差
インサイトライブラリ
すべてのインサイト
ベンチマークデータは Benchmark と Data ページに残します。インサイトでは、そのデータが実際のワークロードに何を意味するかを説明します。
ハードウェア選び · 約10分
ローカル AI ハードウェアの価格性能フロンティア
同じ予算で最も多くのローカル AI 処理をこなすマシンはどれか。価格と 1 日の処理量・書き込み速度・読み取り速度のライブなパレートフロンティアと、その計算方法。
推論システム · 約15分
Strata はなぜ少ない VRAM でも速いのか
図解による総論:エキスパートキャッシュ、CPU と GPU の同時処理、MTP、PCIe ストリーミング、2 枚のカードのリレーを、llama.cpp との実測比較とともに。
エージェント実行時 · 約8分
大きい、しかし遅い:LLM エージェントの最適コンテキストウィンドウ
観測された prefill 挙動と再構築コストから、エージェントがコンテキストを圧縮する時点を選ぶための枠組み。